Gestión del trabajo
Guía de confiabilidad
Las personas, los métodos y las decisiones detrás de equipos que funcionan cuando se necesitan.
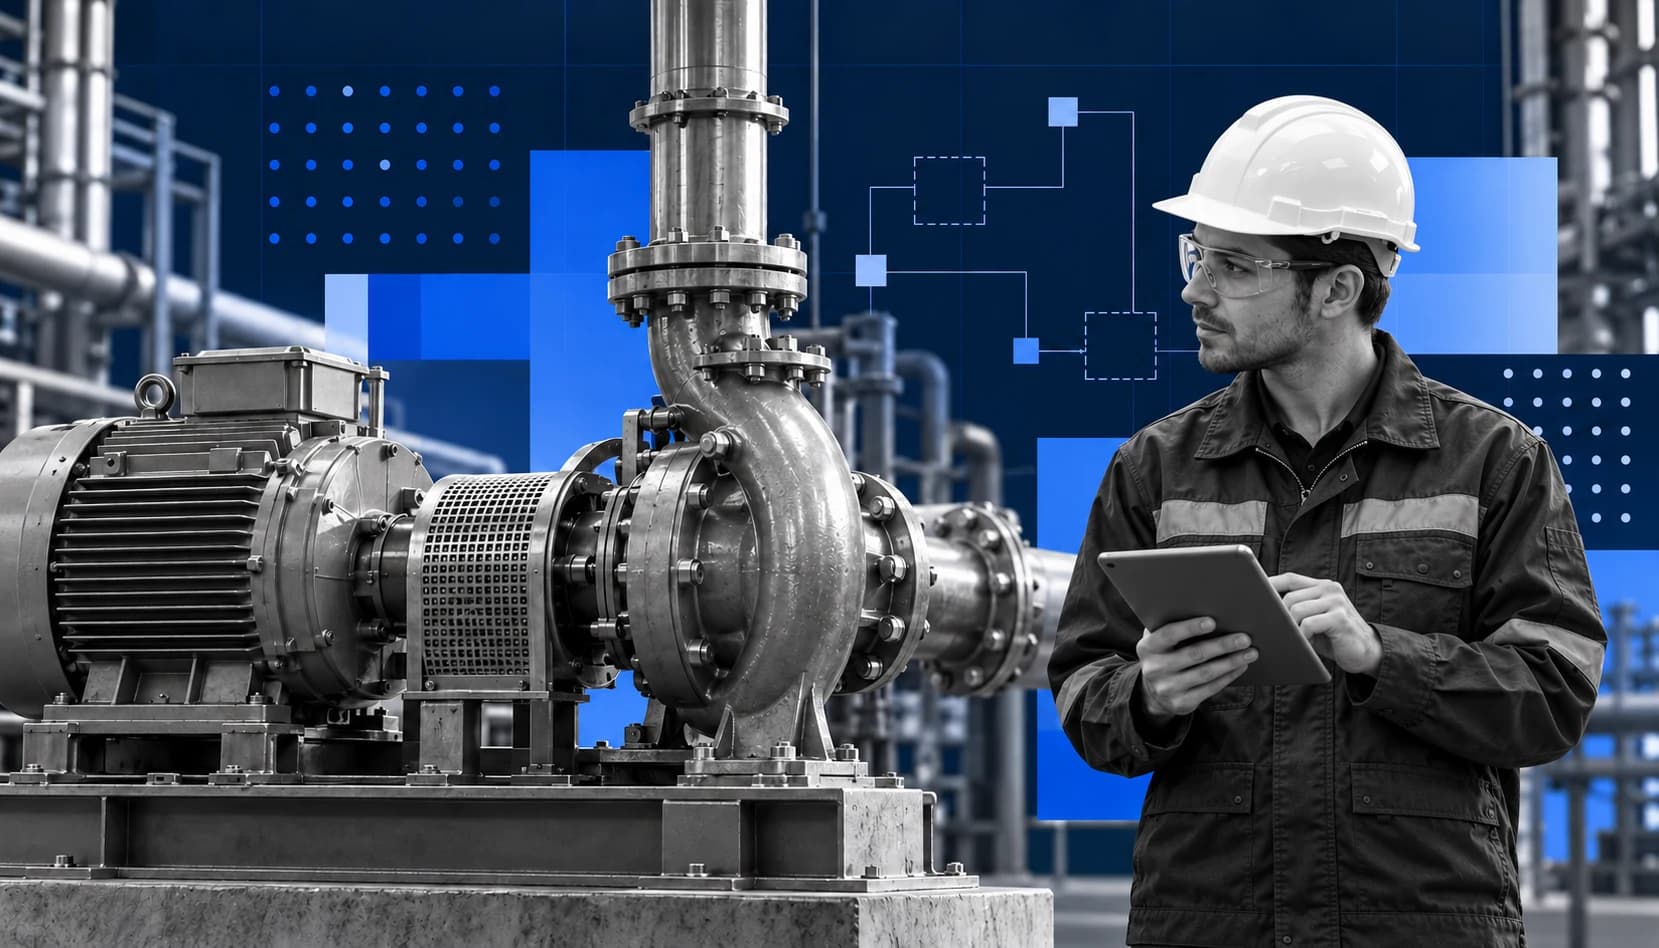
Un ingeniero de confiabilidad estudia cómo fallan los equipos y ayuda al equipo de trabajo a mantener su función requerida, bajo condiciones de operación definidas, durante el tiempo necesario.
En una planta, conecta el análisis de ingeniería con el trabajo en piso. Revisa el historial de fallas, las condiciones de operación, las prácticas de mantenimiento y el diseño del equipo. El resultado útil es una decisión: cambiar una tarea, corregir una instalación, preparar una refacción o rediseñar un punto débil.
Imagina una bomba de producción que vuelve al taller cada pocas semanas. Cada reparación restablece el servicio. La pregunta de confiabilidad es qué la sigue dañando, qué evidencia permitiría establecer la causa y qué debe cambiar antes de la siguiente falla.
Esta guía aborda equipos físicos de manufactura, procesamiento e instalaciones. La confiabilidad depende tanto del diseño como de la operación y el mantenimiento. Operadores, técnicos, planeadores e ingenieros aportan evidencia.
Un programa útil recorre todo el trabajo: identificar el problema, entender su consecuencia, preparar la respuesta y comprobar el resultado. El ingeniero ayuda a conectar esos pasos.
Los puestos se traslapan y sus nombres cambian según la organización. Ambos pueden investigar fallas, mejorar diseños y desarrollar planes. La diferencia suele estar en dónde concentra su atención cada persona.
| Enfoque | Ingeniero de confiabilidad | Ingeniero de mantenimiento |
|---|---|---|
| Pregunta habitual | ¿Qué cambios harán más consistente el desempeño del equipo? | ¿Cómo mantener, diagnosticar y restablecer este equipo? |
| Trabajo frecuente | Patrones de falla, revisión de riesgos, ajustes de estrategia y verificación de mejoras. | Apoyo técnico a reparaciones, métodos de trabajo, ejecución y modificaciones. |
| Responsabilidad compartida | Aportar evidencia y definir el cambio con el equipo. | Hacer viable el cambio y registrar lo ocurrido durante el trabajo. |
Empieza por la decisión que necesitas tomar. Una investigación breve con evidencia sólida puede aportar más que un modelo complejo basado en registros inconsistentes.
ASQ: análisis de modos y efectos de falla
Departamento de Energía de EE. UU.: enfoques de mantenimiento y RCM
Considera este ejemplo hipotético: una bomba de proceso presenta fallas repetidas de rodamientos. El historial muestra varios reemplazos, pero pocos datos sobre carga, alineación, lubricación o estado de las piezas retiradas.
Elige pocas métricas que respondan una pregunta real. Define la población de equipos, el periodo, el evento y los límites de tiempo antes de comparar resultados.
| Métrica | Cálculo | Qué revisar |
|---|---|---|
| Tiempo medio entre fallas (MTBF) | Tiempo de operación registrado ÷ fallas contabilizadas, para equipos reparables. | Comparar servicio y definiciones equivalentes. Un promedio no es una cuenta regresiva. |
| Tiempo medio de reparación (MTTR) | Tiempo total de reparación activa ÷ reparaciones terminadas, con esa definición. | Aclarar si incluye diagnóstico, pruebas y demoras. Medir aparte la restauración total cuando incorpora esperas. |
| Disponibilidad observada | Tiempo operativo ÷ (tiempo operativo + tiempo fuera de servicio), dentro del periodo definido. | Aclarar el tratamiento de paros planeados, tiempo en reserva y periodos sin demanda. |
| Fallas repetidas | Cantidad de recurrencias del mismo modo de falla dentro de un periodo acordado. | Mantener el alcance y la ventana de recurrencia. Revisar los eventos detrás del total. |
En una bomba reparable hipotética, 1,200 horas de operación y tres fallas dan un MTBF observado de 400 horas. Describe ese periodo. No significa que el siguiente rodamiento durará 400 horas, y tres eventos aportan evidencia limitada sobre un patrón de largo plazo.
Combina las métricas de resultado con evidencia de seguimiento: acciones correctivas terminadas, inspecciones con hallazgos útiles y órdenes con notas de cierre significativas. Completar más tareas sirve cuando atienden los modos de falla correctos.
Conocer el equipo da contexto a la investigación. Aprende cómo opera el proceso, qué debe entregar el activo y cómo se desgastan sus componentes. Escucha a operadores y técnicos: los cambios en sonido, carga, temperatura e historial orientan la siguiente pregunta.
Las habilidades de datos ayudan a ponerla a prueba. Revisa marcas de tiempo, agrupa modos de falla, calcula exposición e identifica vacíos. Las técnicas estadísticas aportan valor cuando sus supuestos corresponden al equipo y a sus registros.
La comunicación convierte el hallazgo en acción. Explica evidencia, incertidumbre, trabajo propuesto y criterios de aceptación para que planeación, técnicos y operación puedan usarlos. Conserva el detalle técnico que cambia una decisión.
Se puede llegar al campo mediante estudios de ingeniería, experiencia en mantenimiento o ambos. Los requisitos dependen del empleador y del puesto. Construye un portafolio de investigaciones, revisiones de tareas y mejoras cuyos resultados puedas explicar.
La certificación Certified Maintenance & Reliability Professional (CMRP) de SMRP cubre gestión del negocio, confiabilidad del proceso de manufactura, confiabilidad de equipos, organización y liderazgo, y gestión del trabajo. Certified Reliability Engineer (CRE), de ASQ, aborda conocimientos y métodos de ingeniería de confiabilidad.
Consulta la información vigente de cada organismo para conocer elegibilidad, contenido del examen y recertificación. Elige la formación según el trabajo que necesitas aprender a hacer mejor.
Al iniciar un puesto o un programa pequeño, elige un grupo de equipos y una pérdida recurrente. Esta secuencia es una propuesta, no una promesa de resolver toda falla en 30 días.
Un sistema de gestión de mantenimiento computarizado (CMMS) puede conservar los registros que necesita el programa de confiabilidad. El criterio de ingeniería sigue en manos del equipo: qué falló, qué significa la evidencia y qué cambio está justificado.
Haz que cada trabajo terminado le sirva a la siguiente persona. Registra equipo, condición de operación, defecto observado, trabajo realizado, refacciones usadas, verificaciones y seguimiento. Distingue una causa sospechada de un hallazgo confirmado.
Usa ese historial al preparar la siguiente orden y revisar tareas preventivas. La conexión entre observación, trabajo preparado y resultado registrado integra la confiabilidad al mantenimiento diario.
El enfoque también se apoya en Maintenance and Reliability Best Practices (2009), de Ramesh Gulati. Los ejemplos son ilustrativos; no se presentan resultados de clientes ni referencias numéricas de la industria. Los enlaces de ASQ, SMRP y el Departamento de Energía amplían los métodos y las certificaciones.
Sigue explorando
Conoce Canary